
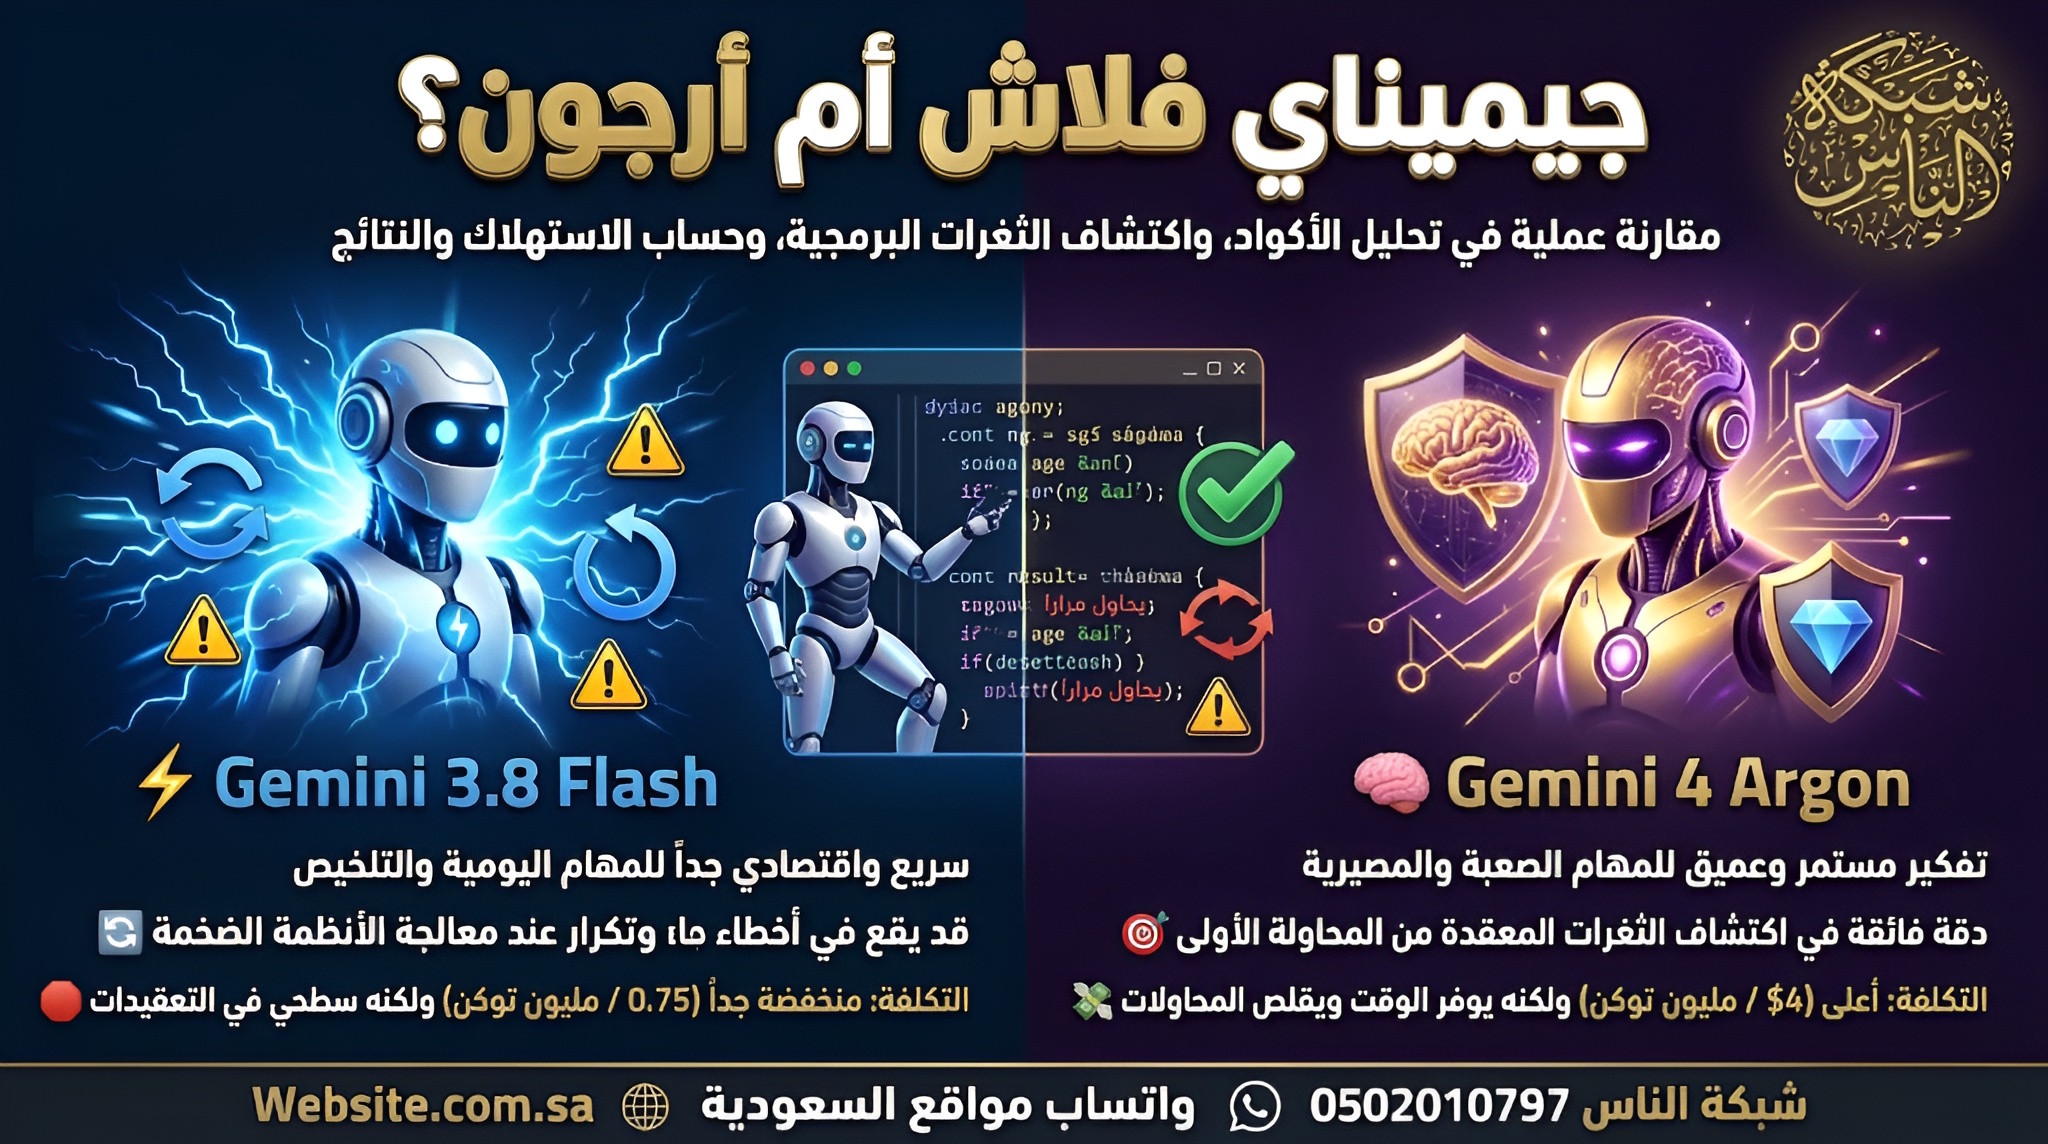
جيميناي فلاش أم أرجون؟ كيف تختار نموذج الذكاء الاصطناعي الأفضل للمهام البرمجية المعقدة
دليل مقارنة الأداء والتكلفة بين نماذج Gemini لاكتشاف الثغرات الأمنية وبناء برمجيات خالية من الأخطاء
هل واجهت يوماً ثغرة أمنية خفية داخل مئات الأسطر البرمجية ولم تعرف كيف ترقعها دون تعطيل وظائف النظام الأخرى؟ 💻 في عالم الذكاء الاصطناعي اليوم، يقف المطورون وأصحاب المشاريع أمام خيارين حاسمين: السرعة والاقتصاد مع نموذج “فلاش”، أو الاستنتاج العميق والمكلف مع نموذج “أرجون”. اختيار النموذج الخاطئ لمعالجة مهمة معقدة قد يدخلك في دوامة مرهقة من الأخطاء المتكررة وإهدار الموارد. نكشف لك في هذا التحليل متى يجب عليك الاعتماد على قدرات Argon الخارقة في التفكير المستمر، وكيف يمكن لتقليص المحاولات الفاشلة أن يوفر ميزانيتك ويسرع إطلاق مشروعك بأمان. 🚀
المثال الأبرز لمهمة يمكن تنفيذها بنموذج “جيميني فلاش” (Gemini 3.8 Flash) ولكنها مصممة خصيصاً لتناسب قدرات “جيميني أرجون” (Gemini 4 Argon) هو: اكتشاف ثغرة أمنية معقدة في نظام برمجي ضخم (أو تحليل مستندات قانونية/طبية شديدة الكثافة) وتصحيحها عبر خطوات استنتاجية متعددة.
نموذج “Flash” مصمم ليكون حصان العمل السريع والاقتصادي للمهام اليومية، بينما “Argon” هو النموذج الرائد للتفكير العميق والاستنتاج المعقد (Sustained Reasoning). إليك تفصيل كيفية تعامل كل نموذج مع هذه المهمة، والفرق الدقيق في الاستهلاك والنتائج:
وصف المهمة (اكتشاف ثغرة برمجية معقدة وترقيعها) تتطلب المهمة قراءة مئات الأسطر من الأكواد عبر ملفات متعددة، وفهم الترابط المنطقي بينها، واكتشاف ثغرة خفية (مثل تسريب بيانات متسلسل)، ثم كتابة كود تصحيحي (Patch) متوافق تماماً مع بنية النظام دون التسبب في أعطال جديدة.
التنفيذ باستخدام Gemini 3.8 Flash
- النتائج: سينهي النموذج قراءة الكود بسرعة كبيرة وسيقترح تعديلات، لكنه غالباً سيلتقط الأخطاء السطحية فقط. عند الضغط عليه في المهام الكثيفة والمعقدة، يُظهر “Flash” ثقة مفرطة في إجابات خاطئة ومبنية على قراءة غير دقيقة للسياق. قد يكتب كوداً يبدو صحيحاً ظاهرياً ولكنه يكسر وظائف أخرى في النظام عند التطبيق.
- الاستهلاك (التكلفة والتوكنز): يُعد الخيار الأرخص بتكلفة تبلغ حوالي 0.75$ لكل مليون توكن مُدخل، و3.75$ لكل مليون توكن مُخرج. ورغم سرعته في الاستجابة (حوالي 57 توكن/ثانية)، إلا أن افتقاره للاستنتاج العميق سيضطرك كمطور إلى تقديم توجيهات متكررة (Prompts) لتصحيح أخطائه. هذا التكرار يعني استهلاكاً أكبر للتوكنز والوقت في دورة مرهقة من التجربة والخطأ.
التنفيذ باستخدام Gemini 4 Argon
- النتائج: يتعامل “Argon” مع المهمة كمهندس خبير. يتميز بقدرته الفائقة على الاستنتاج المستمر وربط النقاط المتباعدة في سياقات طويلة. سيتمكن من اكتشاف الثغرة الحقيقية، والتحقق منها ذاتياً، ثم تقديم حل برمجي دقيق وفعال من المحاولة الأولى أو الثانية. يتفوق النموذج بشكل حاسم في معالجة النصوص الكثيفة كالأكواد المتشابكة أو المصطلحات القانونية الصارمة دون فقدان التركيز.
- الاستهلاك (التكلفة والتوكنز): يُعد نموذجاً باهظ الثمن، حيث تقفز تكلفته إلى 4$ لكل مليون توكن مُدخل، و20$ لكل مليون توكن مُخرج، كما أنه يستهلك حصص الاستخدام (Usage limits) بشكل أسرع. ومع ذلك، فهو يتميز بـ “كفاءة الاستنتاج”؛ حيث يحتاج إلى عدد خطوات ومحاولات أقل بكثير لحل المشكلة. (في تجارب قياسية للمطورين، تمكن Argon من إنجاز مهام معقدة متعددة المراحل باستخدام توكنز إجمالية أقل من النصف الذي استهلكه Flash لمحاولة إنجاز نفس المهمة بفضل تقليصه للحاجة إلى المحاولات المتكررة).
الخلاصة المباشرة استخدم “Flash” لمهام الأتمتة اليومية، وتلخيص الملفات، والبرمجة الخفيفة حيث تكون تكلفة الخطأ منخفضة. وانتقل إلى “Argon” عندما يكون الخطأ غير مقبول، وتحديداً في المهام التي تتطلب تفكيراً معقداً، أو أبحاثاً مالية، أو صياغة قانونية دقيقة، أو تصحيحاً برمجياً عميقاً؛ فتكلفته المرتفعة يقابلها توفير هائل في وقت المراجعة اليدوية المتكررة.
رابط مختصر لمشاركة هذه الصفحة: